假设团队要在一台 Linux 网关上先跑通本地问答,随后把同类能力放进 RK3588 设备和手机 App。一种看似直接的选法是:四个运行时各跑一次,按 tokens/s 排名,最快的作为统一技术栈。
这个顺序会漏掉更早的否决条件:现有模型能否生成目标运行时可加载的制品?加速后端是否支持指定芯片?更新模型时,谁负责重新转换、编译和随 App 或设备固件发布?
先按交付目标缩小路线,再测速度。通用 Linux/CPU 或已支持的 GPU 上,若团队持有可用 GGUF 并需要轻量本地服务,llama.cpp 是可先验证的起点;明确要使用 Rockchip 支持芯片的 NPU,则先核对 RKLLM 的模型转换、Runtime 和驱动组合;已有 PyTorch 模型且移动 App 团队要管理端侧推理,可评估 ExecuTorch 的导出与设备后端;若愿意承担面向目标 GPU 的模型库编译和应用打包,MLC LLM 是另一条路径。它们并非四个可互换的播放器,也没有一个脱离硬件、模型与版本的全局性能名次。
下文只依据各项目公开文档讨论可交付路径。尚未在目标设备上以锁定模型、量化、上下文和提示集完成可比测试,因此不提供生成速度、首 token 延迟、峰值内存或功耗排名。官方后端清单也会变化,最终可用性须以项目锁定版本和目标设备为准。
第一刀不是比较速度,而是确认你能交付什么文件
四种方案的差别先体现在模型离开开发机后是什么。llama.cpp 的常见部署入口是与其实现兼容的 GGUF 模型;它提供 CLI 和服务入口,并列出 CPU、Metal、CUDA、Vulkan 等不同后端。这个广度使它适合用来验证“同一类本地模型能否在多种通用机器上启动”,但 README 的后端列表不是每块具体板卡都可用、每种算子都会落在加速器上的保证。llama.cpp 官方 README
RKLLM 的交付对象不同。Rockchip 文档把 PC 端 RKLLM-Toolkit 转换与量化、板端 RKLLM Runtime C/C++ 接口、RKNPU 驱动列成一条链,模型被转换成 RKLLM 格式后再在受支持的芯片上运行。当前官方仓库列出 RK3588、RK3576、RK3562 和 RV1126B 系列;具体模型与量化选项仍要核对对应 SDK 和固件版本。手里只有一个 GGUF 文件,不能因为目标板也有 Linux 就认定它会经 RKLLM 使用 NPU。Rockchip RKLLM 官方仓库
ExecuTorch 从 PyTorch 导出模型,产出供端侧 Runtime 加载的 .pte。它的 LLM 路径还涉及 tokenizer、生成循环、量化与目标后端;.pte 不是“所有手机和加速器通用的模型文件”。选定 XNNPACK、Vulkan、Core ML 或特定 NPU 后,仍需检查导出、算子覆盖和目标设备运行结果。若应用本来就维护 PyTorch 模型与移动端原生代码,这条链的优势在于模型导出和 App 集成职责比较清楚,而不是自动获得某种速度。ExecuTorch LLM 入门、后端说明
MLC LLM 则把权重转换、配置生成和面向目标设备的模型库编译放到交付链中;其文档说明模型库可显式编译,也可在某些 Python 路径下 JIT 编译。做 iOS/Android 产品时还要决定权重是否随包携带、何时下载、如何与库及 App 版本配套。它不是把任意 GGUF 或 .pte 改后缀就能运行的“统一格式”。编译与打包能力有价值,但把这条构建链长期维持在 CI 中,也是产品团队要承担的成本。MLC LLM 模型库编译、移动端库与权重打包
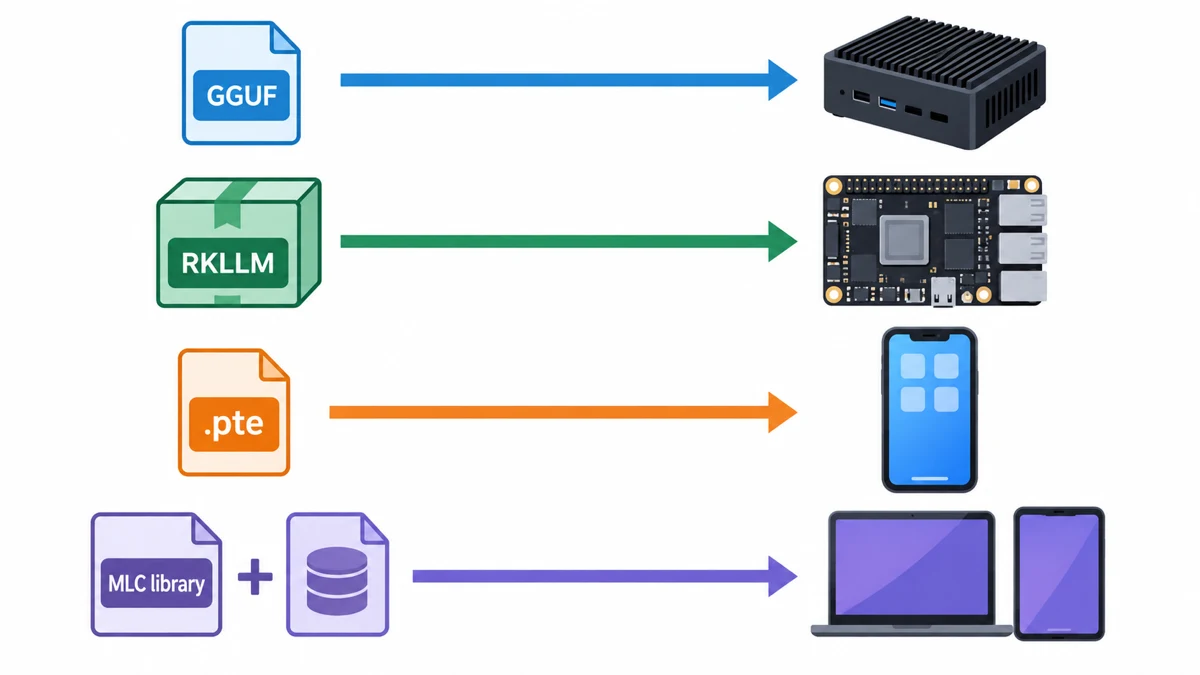
| 先问的交付问题 | llama.cpp | RKLLM | ExecuTorch | MLC LLM |
|---|---|---|---|---|
| 典型模型制品 | 兼容 GGUF | 转换后的 RKLLM 模型 | 按目标导出的 .pte,加上生成所需组件 |
转换权重、配置与目标平台模型库 |
| 应先核对的设备边界 | 具体 CPU/GPU 后端和模型支持 | Rockchip 芯片、Toolkit/Runtime/驱动组合 | 目标 App 平台、delegate 与算子覆盖 | 目标编译后端、运行库及打包链 |
| 最容易漏掉的维护工作 | GGUF/量化版本与服务配置 | 模型转换和板端软件版本锁定 | 导出回归、App API 与后端兼容 | 每个目标的编译、库和权重分发 |
这张表是筛掉不成立路线的起点,不是性能评分表。同一模型家族名不代表四个制品的权重、量化、tokenizer、上下文配置或生成逻辑相同。若组织要求一份模型文件原样发到所有设备,先确认这一要求是否合理;多数情况下需要维护同一模型来源下的多个经验证制品,并在发布记录中逐一标明来源与目标。
把硬件要求和产品更新方式放到同一张选择单
Linux 网关先验证功能,再决定是否绑定 NPU
考虑一台主要做现场设备手册问答的 Linux 网关。项目还没选定 NPU,只知道网络可断、需要本地 API,目标是先验证可用模型与检索链路。这时先用 llama.cpp 的受支持模型与本地服务做功能原型比较直接:模型和问答流程可以先分开验收,后续再测 CPU 或受支持 GPU 的资源占用。如果网关最终限定在 Rockchip 芯片,且 NPU 加速成了硬需求,就不能把原型“直接搬进 NPU”;应另起 RKLLM 转换、驱动兼容与回答一致性验证。是否值得增加这套转换链,要由目标设备上的收益和维护成本共同决定,而非原型机的速度推断。
移动 App 要把模型更新放进发布链
再考虑一个需要把离线摘要嵌入 Android/iOS App 的团队。它已有 PyTorch 训练与评测流程,要求模型和 App 版本一起灰度发布。此时 ExecuTorch 值得先做一条端到端最小链:导出一个被支持的模型,明确 tokenizer 和生成代码由谁维护,在目标手机上验证 CPU 或指定 delegate。若团队更倾向于为多个 GPU 目标构建专用模型库,并能维护 TVM/MLC 编译及打包基础设施,则可并行评估 MLC LLM。两条路都涉及 App 大小、离线首次启动、权重更新和回滚;仅看到“支持 Android/iOS”不能选定产品架构。
这两个任务的“同一个模型”也可能不是同一测试对象。量化方式不同,输出文本质量可能变化;后端算子不覆盖时,可能出现导出失败、回退到 CPU 或必须换模型结构。因而先把可用的模型候选和设备能力写成可检查的配对:模型来源与版本 → 转换/导出版本 → 量化方式 → 目标后端 → 运行库/驱动 → tokenizer 与生成配置。只写“选 RKLLM”或“选 MLC”,无法解释一次升级失败时到底该回退哪一层。
如果产品要持续 OTA,这张配对表还应进入发布工单。模型权重、运行时、驱动和应用接口未必能各自独立升级;先在小范围设备重放固定问题集,再扩大灰度。这个版本管理问题与边缘 AI 模型、固件和配置版本的拆分相通,但本文关注的是选运行时之前必须承认的制品依赖,不重复讨论 OTA 流程。
如果网关场景还要回答设备手册问题,离线设备手册 RAG 的版本、权限与引文边界仍需单独验收;运行时选型不能替代应用层的证据控制。
不要让一张 tokens/s 截图替你决定架构
要比较两个候选,先固定“相同”的含义:相同目标设备、供电和散热条件;相同模型来源、权重及可接受的量化差异;相同 tokenizer、prompt、上下文长度、并发数和生成上限。然后分别记录冷启动、首 token 时间、持续输出、峰值内存、温度、功耗和回答质量。若格式转换导致算子或量化不同,不能把结果当成完全同条件的运行时横比,应把差异写进结论。此处列的是建议的验收设计,不是已经取得的测试数据。
性能测试之前还有三个更便宜的闸口。其一,转换或导出能否稳定完成,生成的制品能否在指定版本 Runtime 加载;其二,目标后端是否真的执行了预期计算,有无无法接受的 CPU 回退;其三,失败后能否回到上一套模型、Runtime 与配置。三关有一关不成立,哪怕演示视频很快,也不适合作为量产路线。
把业务体验也放进验收。现场问答需要的是在可接受等待时间内给出可追溯来源,手机 App 需要的是可控的首次下载和无网可用性,工业终端还可能要与摄像头、UI、网络任务争用内存。不同任务的瓶颈不一样;平均解码速度不能代替首屏响应、内存峰值或长时间热稳定。没有目标设备与固定版本记录时,可以提出这些测试项,但不能声称哪条路线已胜出。
什么时候不该沿用第一候选
如果现成 GGUF 在 Linux 原型上跑通,但产品合同明确要求特定 Rockchip NPU,llama.cpp 仍可能有价值,却不应仅凭通用后端列表承诺该 NPU 路径。先用目标板确认可用 backend;确需 Rockchip 官方链时再评估 RKLLM。反过来,如果硬件尚未锁定、模型频繁更换且团队无力维护转换矩阵,过早绑定 RKLLM 会把原本可替换的模型探索变成固件兼容项目。
如果移动团队已有成熟 PyTorch 导出和原生应用流水线,ExecuTorch 是可核验的候选;但目标模型无法稳定导出、关键算子没有目标 delegate 覆盖时,不应靠“移动端友好”标签继续投入。MLC LLM 面向多平台编译有吸引力,但没有人维护 TVM/编译、模型库与权重包的版本关系时,也不是低成本捷径。可考虑先用更简单的路径证明业务功能,等目标设备、应用分发与模型更新频率固定后再引入复杂链路。
因此,一个可执行的选择不是“四选一”的口号,而是一份短的责任清单:目标设备是什么、能交付哪种模型制品、希望使用哪个后端、失败后回退到哪组版本、谁维护转换与应用集成。回答不了其中任何一项,就先在一台目标机上完成最小验证,并记录不能满足的条件。若目前只是想了解Ollama 本地 AI 的部署边界,可以从上层应用入口读起;这篇文章讨论的是入口之下的模型制品和设备运行责任。
参考资料与适用范围
上述链接支持公开功能与部署链判断;本文没有目标机实测结果。正式选型前,仍须把每个项目的具体版本、模型许可证、目标系统与后端限制重新核对,并把失败样例和回滚结果留档。