把一个约 2 GB 的模型文件放进 8 GB 设备,系统并不会自动剩下 6 GB 可供对话。文件大小只覆盖权重制品的一部分问题:上下文会占 KV cache,运行时会申请计算缓冲,系统、显示服务或检索进程也在用同一块内存。
若同时服务多个会话,缓存需求还会随实际请求形状变化。容量预算应从这些占用逐项列账,再到目标整机核对峰值;不能从“参数量 × 每参数位数”直接宣布设备合格。
拿到模型结构后,先算 KV cache 的理论基线;拿到量化制品后,再记实际文件字节数。工作区、系统服务和并发峰值则留给目标整机测试,不能凭公式补出来。还没选定硬件的团队可先看边缘大模型硬件选型顺序;这里专门把容量预算算清楚。下文数值都是假设参数的算例,不是板卡测试结果。
先把一个内存数字拆成五本账
采购表上常见的“模型需要 4 GB”至少有五种可能含义:模型文件占用的存储、权重装载后的驻留、KV cache、推理计算缓冲,以及整机运行时所需的系统余量。混用其中任意两个,估算就无法复核。
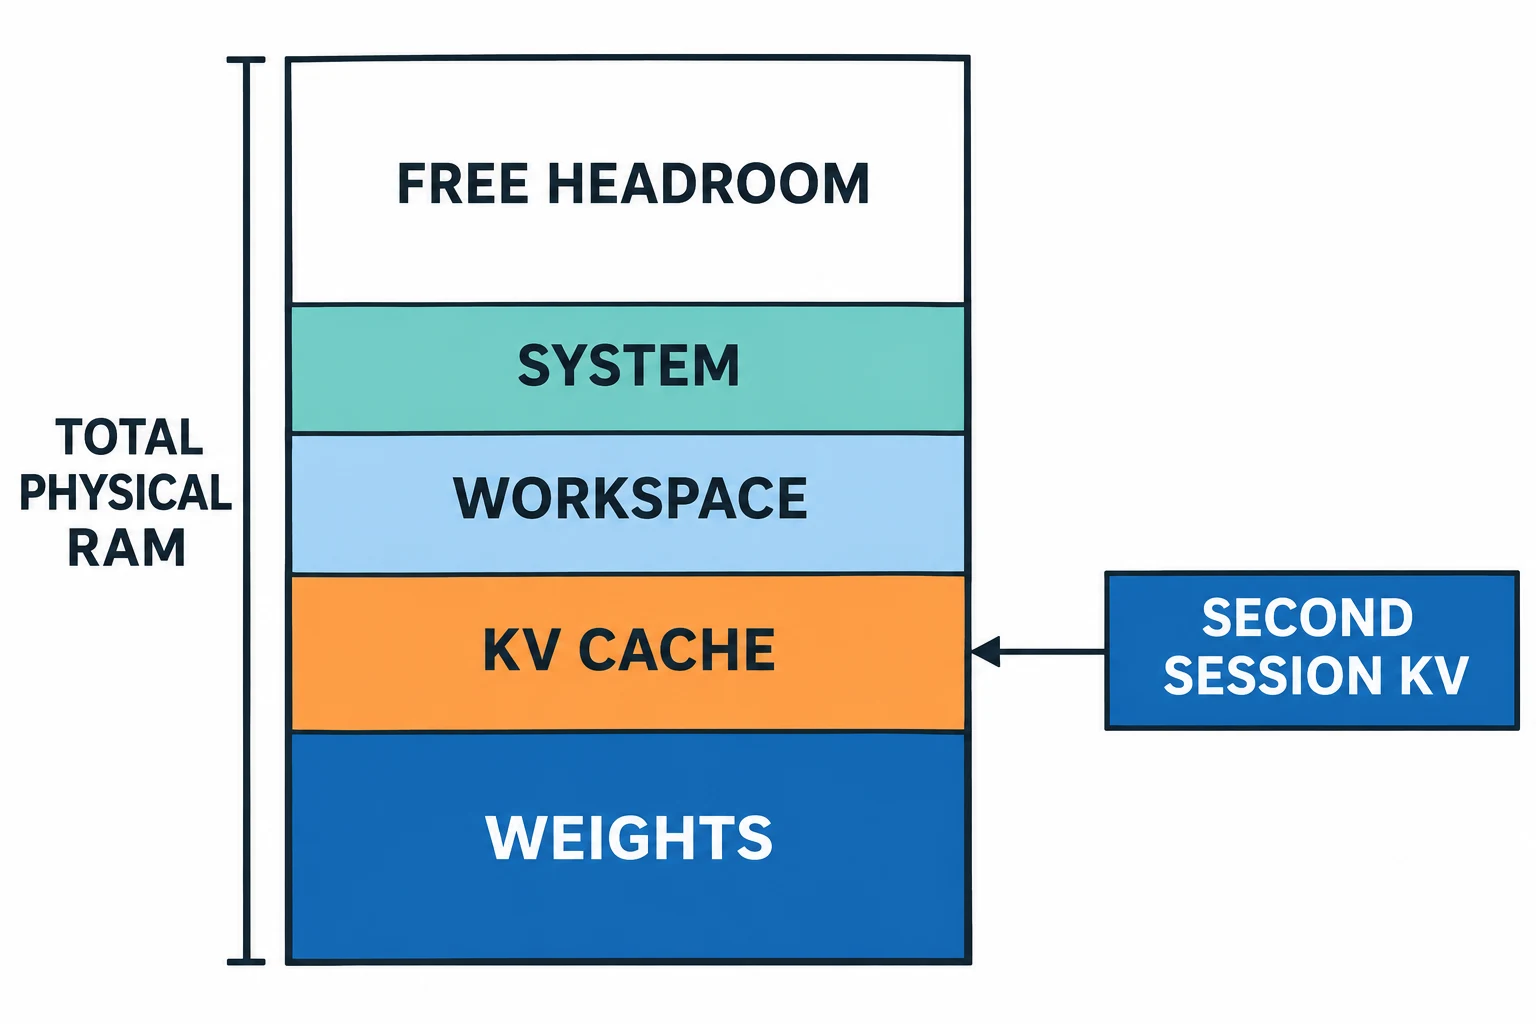
图为概念分层,不按比例表示容量,也不是任何设备的实测。顶部空白是尚未分配的余量,不是第五项已占用内存;第二个会话的 KV 需求若实际分配,会挤占这块余量,具体大小须看运行时策略。
| 账目 | 可先从哪里取得 | 不能据此推断什么 |
|---|---|---|
| 权重与模型元数据 | 固定版本、量化格式与模型文件;记录实际字节数 | 文件大小不等于进程峰值,也不包含全部运行时分配 |
| KV cache | 模型层数、KV 头数、头维度、上下文和缓存数据类型 | 标称最大上下文不等于每次实际占用;分配策略由运行时决定 |
| 计算工作区与图缓冲 | 目标运行时启动日志、内存分解或目标机测量 | 不能用参数量乘一个通用系数替代 |
| 系统与伴随任务 | 目标镜像启动后的可用内存,以及显示、检索、语音等常驻服务 | 标称 RAM 不等于应用可独占的 RAM |
| 多会话与安全余量 | 上限并发、每会话输入/输出长度和整机峰值记录 | 并发不一定是简单乘整个模型;也不能默认共享缓存完全免费 |
最终预算是这些账目在同一运行配置、同一时间窗口下的整机占用上界,而不是把不同机器、不同运行时日志中各自的最高数字相加。先列初估范围,再跑目标负载拿到峰值、失败与内存回收记录。若只能给出 GGUF 或其他权重文件大小,目前仍只是存储筛选,尚未完成 RAM 选型。
权重的理论下界不能写成设备需求
假设模型有 30 亿个参数,若每参数恰好 4 bit,裸权重算术下界为 3,000,000,000 × 4 ÷ 8 = 1,500,000,000 bytes,约 1.40 GiB。8 bit 则约 2.79 GiB,16 bit 约 5.59 GiB。这里用十进制参数量与二进制 GiB 换算,避免把 GB 和 GiB 混写。
这个算式没有计入量化块的 scale、零点、可能保留高精度的张量、嵌入或输出层、模型头部和对齐。实际量化制品应以固定 hash 的文件大小及运行时加载日志为准;“Q4”“INT4”也不是可跨运行时互换的统一字节数。
权重量化改变的是权重账,不会自动把 KV cache、计算图和操作系统占用按相同比例缩小。格式是否被目标后端支持,还要核对运行时版本。llama.cpp 的 server 配置将模型加载方式、设备卸载、上下文与 K/V 缓存类型分别列为参数,正说明这些账目不能合并成一个标签。
内存映射也不是“模型不占 RAM”
运行时用内存映射读取模型时,文件页可能按访问进入页缓存,并可能被多个进程共享。文件存在磁盘上,不代表推理期间不占物理内存;单个进程 RSS 又可能把共享页算入,不能直接当成整机独占成本。Linux 的 smaps_rollup 文档提供 RSS/PSS 等字段,PSS 把共享映射按进程分摊,但它也不能单独回答是否还有足够 GPU/NPU 设备内存或连续可分配空间。做容量决策时,至少同时记录进程指标、系统可用内存、容器限制及 OOM/交换事件,并说明采集点。
KV cache 用模型结构计算,不用“7B”猜
在自回归推理中,已处理 token 的 key 和 value 会留在缓存里,供后续 token 的注意力计算复用;缓存按层存在,长度随可用上下文和运行时分配策略变化。Hugging Face 的缓存原理文档解释了 K/V 的逐层保存。一个不考虑特殊布局、压缩和对齐的理论算式是:
KV 字节数 ≈ 2 × 层数 × KV 头数 × 每头维度 × 已分配 token 数 × 每元素字节数 × 会话数
前面的 2 是 K 与 V 两份张量。这里要填的是 KV 头数,不是看到配置里的 attention query heads 就直接照抄;采用 grouped-query 或 multi-query attention 的模型,两者可能不同。K/V 若使用不同精度,也应分开算再相加。模型有滑动窗口、混合注意力层或跨层缓存复用时,这个统一层数公式不再完整,须按实际模型结构和运行时日志逐层修正。
一组纯计算算例
假设某模型有 32 个标准注意力层、8 个 KV 头、每头 128 维,K 与 V 都按 2 bytes/元素存储,每个会话分配 4096 token。单会话理论缓存为 2 × 32 × 8 × 128 × 4096 × 2 = 536,870,912 bytes,即 512 MiB。若两个会话各自按相同上限完整分配,理论值是 1024 MiB。若把每会话上限改成 8192 token,在相同结构与精度下理论缓存翻倍。
**512 MiB 不是某个商用模型或某块板的测量结果。*其中 4096 是假设的分配 token 数*,不是“用户输入字数”;提示词、检索片段和生成空间都要占 token 预算。实际运行时可预分配、按需扩展、复用槽位,或为批处理、页表与对齐增加额外占用。一次 100 token 的短问答不能证明配置为 4096 token 时的峰值,更不能证明两个会话同时达到长上下文时不会 OOM。
量化缓存与卸载是另一笔交易
降低 K/V 缓存精度可减少其名义数据量,却可能引入 scale、残差区或额外转换缓冲,还可能改变延迟和回答质量。把缓存从 GPU 卸到 CPU,也只是改变占用位置和数据传输,不会让整机内存免费增加。Hugging Face 的 KV cache 策略明确把量化与卸载作为带有性能取舍的方案;llama.cpp 的 server 参数又允许分别配置 K 和 V 类型。比较两种配置时,应把模型权重、K/V 类型、上下文、并发、卸载层数和运行时版本写在同一张记录里;不应只在结果旁写“4-bit”。
先给预算表留下实测位置
先固定业务任务:最长输入、保留给输出的 token、并发上限、是否同时做检索/语音/显示,以及能接受的失败和延迟。然后固定模型文件 hash、架构配置、量化制品、运行时版本、后端、上下文上限和缓存精度。拿不到这些条件时,可以做候选区间,不能给采购单写一个“足够内存”的肯定数。
一张预算表至少应有四列:静态估算、启动实测、最长请求峰值、目标并发峰值。静态估算里,权重采用实际制品字节数,KV 用结构公式给出理论基线;工作区和系统占用标为“待测”,不要给它们填一个未经来源支持的固定百分比。
下面是一张可复制的空白模板。每格填数值、单位和采集时间,另附模型文件 hash、运行时版本及原始日志;没有测量的格子保持空白,不用静态估算代填。最后一行同时记录整机峰值和当时 MemAvailable,以免只看进程 RSS。
| 账目(单位统一用 MiB) | 静态估算 | 启动实测 | 最长请求峰值 | 目标并发峰值 |
|---|---|---|---|---|
| 固定权重制品 / 驻留 | 文件换算 MiB:____ | RSS/PSS:____ | RSS/PSS:____ | RSS/PSS:____ |
| KV cache | 结构公式:____ | 已分配:____ | 已分配:____ | 已分配:____ |
| 计算工作区、图缓冲 | 待测 | ____ | ____ | ____ |
| 系统与伴随任务 | 待测 | ____ | ____ | ____ |
整机峰值 / MemAvailable |
不由文件大小推断 | ____ / ____ | ____ / ____ | ____ / ____ |
同一页还要填写输入/输出实际 token、上下文分配上限、真实重叠的会话数、容器限制、交换/OOM 与失败请求。权重文件字节数和 RSS/PSS 是不同口径,不要横向相减当作“额外内存”;整机峰值也不能简单相加上面各行的不同时间点最大值。
启动实测在目标系统加载全部常驻服务和模型后记录;最长请求在明确的输入与输出上限下运行;并发峰值让请求真正重叠,而不是把单会话结果乘以线程数冒充测试。与其争论“8 GB 是否够用”,不如先问这四列里哪一列有数据、哪一列仍是空白。
| 验证条件 | 需要保存的记录 | 触发返工的信号 |
|---|---|---|
| 空载到模型加载完成 | 系统 available、进程 RSS/PSS、模型与运行时日志、设备内存(如适用) | 载入失败、交换持续增长或可用内存接近业务最低值 |
| 最长输入与输出 | 真实 token 数、K/V 分配日志、整机峰值、失败与延迟 | 算式与日志不符、长请求 OOM、缓存增长无法回收 |
| 上限并发与伴随任务 | 各请求长度、实际重叠时段、整机峰值、排队和错误数 | 请求只能串行通过、显示或检索任务挤占内存、失败被平均数掩盖 |
| 运行后的恢复 | 会话结束后的 available、缓存释放策略、连续轮次 | 峰值逐轮上升或空闲状态无法恢复 |
表中的“接近业务最低值”必须由目标设备的故障容忍度和后台任务测出来,不是本文给出的通用阈值。要同时保留 OOM、超时与取消请求,否则只看成功请求的峰值会偏乐观。若使用容器,还应记录 cgroup 限制与容器内外的计数差异;若使用共享内存架构,要把 CPU、GPU 与其他模块的竞争纳入同一整机观察。

这张图只说明决策顺序:理论账用于提出候选,目标机峰值、失败和恢复记录才用于验收。图中的“可接受”由产品负载和故障容忍度定义,本文没有预设通用阈值。
用同一张工作表比较两个配置
让每个候选配置占工作表一行,而不是把“7B、Q4、8 GB”挤成一个单元格。先填不可变列:模型与 tokenizer 的精确版本、文件 hash、运行时构建版本、设备镜像、内存配置和是否存在 CPU/GPU 共享。
再填工作负载列:最大输入 token、预留输出 token、每会话分配的上下文上限、同时在跑的会话数,以及显示、语音、检索等常驻服务是否启用。最后才填权重文件字节数、按结构计算的 KV 理论值、运行时报告的已分配缓存、模型加载后可用内存和最长请求的整机峰值。缺一个关键输入时,保留空格并写出取得它的方法;不要偷偷沿用上一个模型的数值。
为什么要区分“输入”“输出预留”和“已分配上限”?假设业务最长输入 3000 token,回答最多 800 token,系统提示与模板还占 200 token,已经达到 4000 token。若把上下文设置为 4096,剩余空间很少;若实际 tokenizer 让手册片段比估算多出 150 token,这次请求可能先遭遇截断,而不是内存不足。
另一方面,把上下文上限改到 8192 以免截断,某些运行时可能因此提前分配更大的 KV 区。只看当天那段较短的对话,既发现不了截断风险,也发现不了上限带来的容量风险。应分别记录“业务实际最长 token”和“运行时最终分配 token”,否则预算表里的 KV 数字没有可追溯的输入。
因此工作表中的“场景 A”应写真实业务短请求,“场景 B”写输入与输出都接近允许上限的单会话,“场景 C”让两个或更多会话在最长输入阶段重叠。如果设备还要本地检索,则 C 场景也须同时运行检索进程;不能一边停掉检索节省 RAM,一边宣称测的是完整设备助手。每个场景保存请求标识、实际 token 数、开始和结束时间、是否成功、进程与系统峰值、交换/OOM 事件。测试前后确认缓存是否释放;否则第二轮的基线已不等于第一轮。
对同一模型做两种量化格式比较时,复制一行配置,明确只改模型制品及必要的加载参数。不要把量化格式、上下文、会话数与运行时版本一次全改;即使峰值下降,也无法判断哪一个变量起作用。对不同参数规模的模型也是如此:公式的 KV 项要重新读取层数、KV 头数和头维,不能用第一个模型的“每 token 缓存”常数套第二个模型。题库要求两种规模与两种量化格式的实测比较;本文尚无这些原始记录,所以此处只给操作表,不提供比较结论。
一个可执行但尚未执行的复核顺序
- 在目标镜像启动所有常驻服务,记录空载
MemAvailable、容器内存限制与失败事件计数;若设备把显存单独分配,另记显存可用量。 - 加载固定 hash 的模型,保存运行时输出的权重、上下文、KV 与计算缓冲分解;缺少分解字段时,明确标记“运行时未报告”,不得用文件大小补空。
- 先跑短请求确认配置能生成,再跑最长输入与输出上限,最后让并发请求真正重叠;每组保留所有请求的成功、超时和 OOM,而非只挑完成的请求。
- 在请求结束后观察内存是否回到预期空闲状态,再重复几轮。若可用内存逐轮下降,应先查缓存保留策略、进程生命周期或任务积压,而不是立即购买更大内存。
- 用实际记录回填预算表,把“理论 KV”“运行时分配”“整机峰值”并列显示。三者不同是正常的调查起点,不应为了让报告好看而把数字调成一致。
这一顺序不是通用 benchmark 命令:不同运行时可能把权重、KV 或计算缓冲放在不同设备,也可能自动调整未明确指定的参数。实际执行前应关闭会自动改变上下文、卸载比例或缓存类型的未知默认行为,或至少把最终生效配置从启动日志导出。否则工作表记录的是操作者输入值,未必是推理实际使用值。
内存够也不等于答案好或速度够
换成更激进的权重量化,理论权重字节数下降,但任务相关的回答质量、运行时支持和首字等待可能变差。缩短上下文让 KV cache 变小,也可能截断用户真正需要的资料。缓存量化或卸载同样有代价。容量表仅用于淘汰明显放不下的组合,不能替代业务问题集上的答案核查或边缘大模型 TTFT、TPOT 与功耗验收。
如果预算仍超出目标设备,可依次复核是否把标称最大上下文误当成实际业务需要、是否能换支持的量化制品、能否降低并发或拆走伴随任务,再决定换更大内存的硬件。每改变一个变量,就更新模型配置和测试编号,重跑最长请求与并发场景;仅靠新的理论算式不能替代复测。对那些必须容纳长手册、同时运行显示和本地检索的产品,调低上下文或并发可能直接破坏产品需求,不能被当成无损优化。
哪些结构和运行时会让估算失效
上述 KV 算式假定所有计入的层采用普通、独立保存 K/V 的注意力,并按一个固定的每元素字节数存储。若模型使用滑动窗口注意力,缓存可能只保留窗口内的部分 token;若采用混合架构,某些层的状态不是同样形状的 K/V;若运行时把多个请求放进页式缓存,可能按块分配且存在内部碎片。此时“层数 × KV 头数 × 全部 token”只是一种上界或错误近似,必须查目标模型配置和实际分配日志。不可为了让设备看似够用,选择性采用更小的理论值而忽略运行时预留。
权重账也可能因部分层卸载到 GPU/NPU、CPU 侧保留副本、格式转换或算子不支持而改变。针对统一内存设备,CPU 与 GPU 看到的可能是同一物理 RAM,两个 API 报出的占用不能简单相加;针对独立显存设备,系统 RAM 够而显存不足同样会失败。对容器化部署,宿主机尚有可用内存也不意味着容器不会触发自己的限制。这些边界解释了为什么预算要同时写“理论层”和“目标机观测层”。
最后,能加载模型不等于业务请求能完成。最长上下文可能先触发 token 截断、后端不兼容、计算缓冲申请失败或延迟不可接受,而非单纯权重太大。故障记录应分清失败发生在加载、输入处理、生成、并发排队还是会话回收。若无原始日志,不能根据一次 OOM 就宣称“至少需要某个固定 GB 数”;那只是待调查现象,尚不足以定新硬件。
这篇算式能回答什么,不能回答什么
它能把“模型文件是 2 GB,8 GB 设备够不够”改成一组可以检查的问题:该文件对应什么量化制品?模型有多少层、多少 KV 头?运行时分配多长上下文?多少会话重叠?目标镜像和伴随任务先占了多少?计算缓冲和设备内存在哪里?
它不能仅凭参数量推断某个 RK3588、GPU 或 AIHub 设备的实测峰值,更不能得出持续运行、服务质量或可量产结论。本文没有目标板、两种模型规模或两种量化格式的实测记录;上面的 30 亿参数和 512 MiB 算例仅用于展示计算步骤。真正的容量结论应附固定制品、真实负载、整机峰值、失败记录和版本号。没有这些证据时,正确的输出是一份待验证预算,而不是“4-bit 模型一定能跑在 8 GB 板上”。